Info Cuaca

SAUDARA PENGARANG
- AI boleh "hallucinate": jawapan lancar tapi salah; jangan anggap jawapan meyakinkan sebagai benar.
- Uji jawapan: tanya semula dengan ayat berbeza, minta sumber dan bedakan fakta versus andaian.
- Waspada sycophancy: AI boleh ikut pengaruh pengguna dan mengubah jawapan menjadi salah.
- Celik AI: periksa sumber, bandingkan rujukan, minta AI kritik jawapannya sendiri sebelum percaya.
Bayangkan sebuah sistem kecerdasan buatan (AI) diberikan satu masalah matematik yang menghantui ahli matematik selama puluhan tahun. Ribuan ejen AI dikerahkan, berjuta-juta mesej dipertukarkan dan berbilion token digunakan.
Beberapa hari kemudian, sistem itu menghasilkan apa yang didakwa sebagai penyelesaian.
Itulah yang berlaku apabila OpenAI mengumumkan pada 8 September lalu bahawa sistem AI dalamannya menghasilkan penyelesaian bagi masalah Navier-Stokes existence and smoothness, salah satu daripada tujuh Millennium Prize Problems.
Masalah ini termasuk antara persoalan matematik paling mencabar di dunia, dengan hadiah AS$1 juta disediakan oleh Clay Mathematics Institute bagi setiap penyelesaian yang memenuhi syarat.
Lebih menarik, OpenAI melaporkan bahawa kira-kira 10,000 ejen AI terlibat dalam usaha tersebut. Untuk masalah Navier-Stokes sahaja, sekitar 2.7 juta mesej dan 130 bilion output token digunakan.
Penyelesaian itu dicapai selepas kira-kira 88 jam pencarian, sebelum melalui proses pemformalan dan pengesahan lanjut.
Perkembangan ini memberi gambaran betapa pantasnya AI bergerak. Dahulu kita kagum apabila ChatGPT boleh menulis surat rasmi. Kemudian ia membantu mengekod, menganalisis data dan membaca dokumen.
Kini AI mula memasuki wilayah yang selama ini dianggap benteng pemikiran manusia. Namun di sebalik kekaguman itu, ada satu soalan yang lebih dekat dengan kehidupan kita.
Bagaimana kita tahu ChatGPT sedang bercakap benar dan bukannya sedang “kelentong” atau menipu kita?
Persoalan ini penting kerana masalah utama AI bukan semata-mata apabila ia tidak tahu. Masalah lebih besar berlaku apabila ia tidak tahu, tetapi jawapannya kedengaran seolah-olah sangat tahu.
Bayangkan seorang mahasiswa sedang menyiapkan tugasan pada pukul 11 malam. Dia meminta ChatGPT menerangkan sebuah teori, lengkap dengan nama penyelidik dan rujukan.
Dalam beberapa saat, keluar jawapan yang tersusun cantik. Nama jurnal ada. Tahun penerbitan ada. Tajuk artikel pun nampak meyakinkan.
Esoknya, apabila rujukan itu dicari, artikel tersebut sebenarnya tidak pernah wujud.
Dalam dunia AI, keadaan sebegini sering disebut sebagai hallucination. Model menghasilkan maklumat yang kelihatan munasabah tetapi sebenarnya salah, tidak disokong atau direka.
Kajian yang diterbitkan dalam jurnal Nature pada 2024 menunjukkan bahawa masalah ini boleh dikesan sebahagiannya dengan menilai tahap ketidakpastian pada makna jawapan AI melalui pendekatan yang dinamakan semantic entropy.
Bagi pengguna biasa, kita tidak perlu memahami formulanya. Pengajarannya lebih mudah. Jangan anggap satu jawapan yang lancar sebagai bukti bahawa jawapan itu benar.
Cuba tanya perkara yang sama sekali lagi dengan susunan ayat berbeza. Kemudian minta ChatGPT menerangkan sumbernya. Tanya bahagian mana yang merupakan fakta dan bahagian mana yang dibuat berdasarkan andaian.
Jika fakta utama mula berubah, nama kajian bertukar atau angka tidak konsisten, lampu amaran sepatutnya sudah menyala.
Ada satu lagi perangkap yang lebih halus. Kadangkala AI terlalu mahu bersetuju dengan kita.
Fenomena ini dipanggil sycophancy. Kajian yang diterbitkan dalam prosiding AAAI/ACM Conference on AI, Ethics, and Society pada 2025 mendapati model bahasa boleh mengubah respons apabila dicabar pengguna.
Dalam sebahagian keadaan, kecenderungan mengikut pengguna itu menyebabkan jawapan yang asalnya betul bertukar menjadi salah.
Kita sendiri mungkin pernah melakukannya tanpa sedar.
Selepas ChatGPT memberikan jawapan A, kita membalas, “Saya rasa sebenarnya B yang betul. Betul kan?” Lalu AI mula berkata, “Ya, anda betul,” sebelum memberikan hujah baharu menyokong B.
Ketika itu kita mungkin berasa bijak kerana AI bersetuju dengan kita. Sedangkan yang sebenarnya berlaku mungkin lebih membimbangkan: kita sedang mempengaruhi mesin supaya mengesahkan apa yang memang kita mahu dengar.
Di sinilah literasi AI menjadi semakin penting. Celik AI bukan sekadar tahu menulis prompt panjang atau menggunakan aplikasi terbaharu. Celik AI juga bermaksud tahu mencurigai jawapan yang terlalu sempurna.
Apabila sesuatu fakta penting, tanya semula. Minta sumber asal. Buka sumber tersebut dan pastikan ia benar-benar mengatakan perkara yang didakwa. Bandingkan dengan laman rasmi atau sumber lain yang berwibawa.
Kemudian lakukan sesuatu yang jarang kita buat: minta AI mencari kelemahan dalam jawapannya sendiri.
Contohnya, kita boleh bertanya, “Apakah bahagian jawapan tadi yang paling berkemungkinan salah?” atau “Apakah hujah terbaik yang bercanggah dengan jawapan ini?”
Soalan seperti itu mengubah hubungan kita dengan AI. Kita tidak lagi menjadi penerima pasif, tetapi pemeriksa kepada maklumat yang diberikan.
Ironinya, semakin pintar AI, semakin penting kemahiran berfikir manusia.
Jika suatu hari AI benar-benar mampu membantu menyelesaikan persoalan saintifik yang tidak mampu ditembusi manusia, itu sebuah pencapaian besar.
Namun bagi kebanyakan kita, cabaran sehari-hari jauh lebih sederhana: memastikan fakta untuk tugasan anak, laporan pejabat, bahan kuliah atau mesej WhatsApp keluarga tidak diterima bulat-bulat hanya kerana ia datang dalam bahasa yang meyakinkan.
AI boleh menjadi pembantu yang luar biasa. Tetapi pembantu tetap perlu diperiksa.
Masa depan mungkin bukan pertandingan menentukan sama ada manusia atau AI lebih pintar. Cabaran sebenar ialah memastikan manusia cukup bijak untuk mengetahui bila AI patut dipercayai, bila perlu disoal dan bila jawapannya mungkin sekadar “kelentong” yang kedengaran sangat meyakinkan.
Artikel ini merupakan pandangan peribadi penulis dan tidak semestinya mewakili pandangan mahu pun pendirian rasmi RTM.
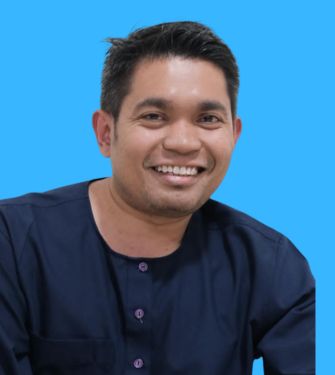
Dr Azril Shahreez Abdul Ghani
Pensyarah Fisiologi dan Pendidikan Perubatan
Kulliyyah Perubatan
Universiti Islam Antarabangsa Malaysia
E-mel: azrilshahreez@iium.edu.my